Un test de D-dimères revient positif chez un patient à faible risque d’embolie pulmonaire. Le résultat est-il fiable ou simplement sensible ? Pour répondre, il faut regarder au-delà de la sensibilité et de la spécificité brutes. L’aire sous la courbe ROC, souvent abrégée A.U.C. (Area Under the Curve), condense la performance globale d’un test diagnostique en une seule valeur. C’est un outil de lecture directe pour les cliniciens qui comparent des marqueurs biologiques ou des scores de risque.
Pourquoi sensibilité et spécificité ne suffisent pas en pratique clinique
Quand on reçoit les résultats d’un dosage (troponine, D-dimères, PSA), le logiciel du laboratoire applique un seuil unique. Au-dessus, le résultat est « positif » ; en dessous, « négatif ». Le problème, c’est que ce seuil est un choix, pas une vérité biologique.
Abaisser le seuil augmente la sensibilité : on détecte plus de malades, mais on déclenche aussi plus de faux positifs. Le relever fait l’inverse. Chaque seuil produit un couple sensibilité/spécificité différent, et se fier à un seul couple masque le comportement du test sur tout le spectre de décision.
C’est exactement ce que la courbe ROC rend visible. Elle trace, pour chaque seuil possible, le taux de vrais positifs (sensibilité) en ordonnée contre le taux de faux positifs (1 moins la spécificité) en abscisse. On obtient une courbe qui part du coin inférieur gauche et monte vers le coin supérieur droit du graphique.
A.U.C. d’un test diagnostique : lire et interpréter la valeur
L’A.U.C. correspond à l’aire totale sous cette courbe ROC. En termes concrets, elle répond à une question simple : si on prend au hasard un patient malade et un patient sain, quelle est la probabilité que le test attribue un score plus élevé au malade ?
Un test parfait donne une A.U.C. de 1,0 : la courbe passe par le coin supérieur gauche, chaque malade est classé au-dessus de chaque sain. Une A.U.C. de 0,5 correspond à la diagonale, c’est-à-dire un classement au hasard, sans valeur discriminante.
Ordres de grandeur en médecine
On considère généralement qu’une A.U.C. autour de 0,7 traduit une discrimination acceptable, autour de 0,8 une bonne discrimination, et au-delà de 0,9 une excellente capacité à séparer malades et non-malades. Ces repères servent à comparer deux marqueurs entre eux pour une même pathologie, par exemple D-dimères contre angioscanner dans le diagnostic d’embolie pulmonaire.
Une A.U.C. élevée ne garantit pas l’utilité clinique du test. Un marqueur peut très bien discriminer dans une cohorte d’étude homogène et perdre sa pertinence face à une population hétérogène en consultation. C’est un point que les revues récentes en imagerie médicale soulignent : les résultats publiés reposent souvent sur des métriques techniques sans validation terrain suffisante.
Comparer deux tests avec la courbe ROC : méthode et pièges terrain
Quand on hésite entre deux marqueurs biologiques ou entre un score clinique et un dosage, on superpose leurs courbes ROC sur le même graphique. Le test dont la courbe se rapproche le plus du coin supérieur gauche domine l’autre sur l’ensemble des seuils.
En pratique, les courbes se croisent parfois. Un test peut être meilleur à haute sensibilité (seuil bas, peu de malades ratés) et moins bon à haute spécificité (seuil haut, peu de faux positifs). Dans ce cas, le choix du test dépend de la conséquence clinique d’une erreur : rater un infarctus n’a pas le même coût qu’un faux positif sur un dépistage de routine.
Probabilité pré-test et prévalence
L’A.U.C. est indépendante de la prévalence de la maladie dans la population testée. C’est un avantage pour comparer des tests entre études. En revanche, les valeurs prédictives (positive et négative) varient fortement avec la prévalence.
- Dans une population à faible prévalence (dépistage de masse), même un test à haute spécificité génère beaucoup de faux positifs en valeur absolue.
- Dans une population à forte prévalence (service de soins intensifs), un test modérément sensible peut suffire parce que la probabilité pré-test est déjà élevée.
- Le rapport de vraisemblance (likelihood ratio) combine sensibilité et spécificité pour ajuster la probabilité post-test patient par patient, ce que l’A.U.C. seule ne fait pas.
Autrement dit, l’A.U.C. dit si le test classe bien dans l’absolu. Mais la décision clinique demande de croiser cette performance avec le contexte du patient.
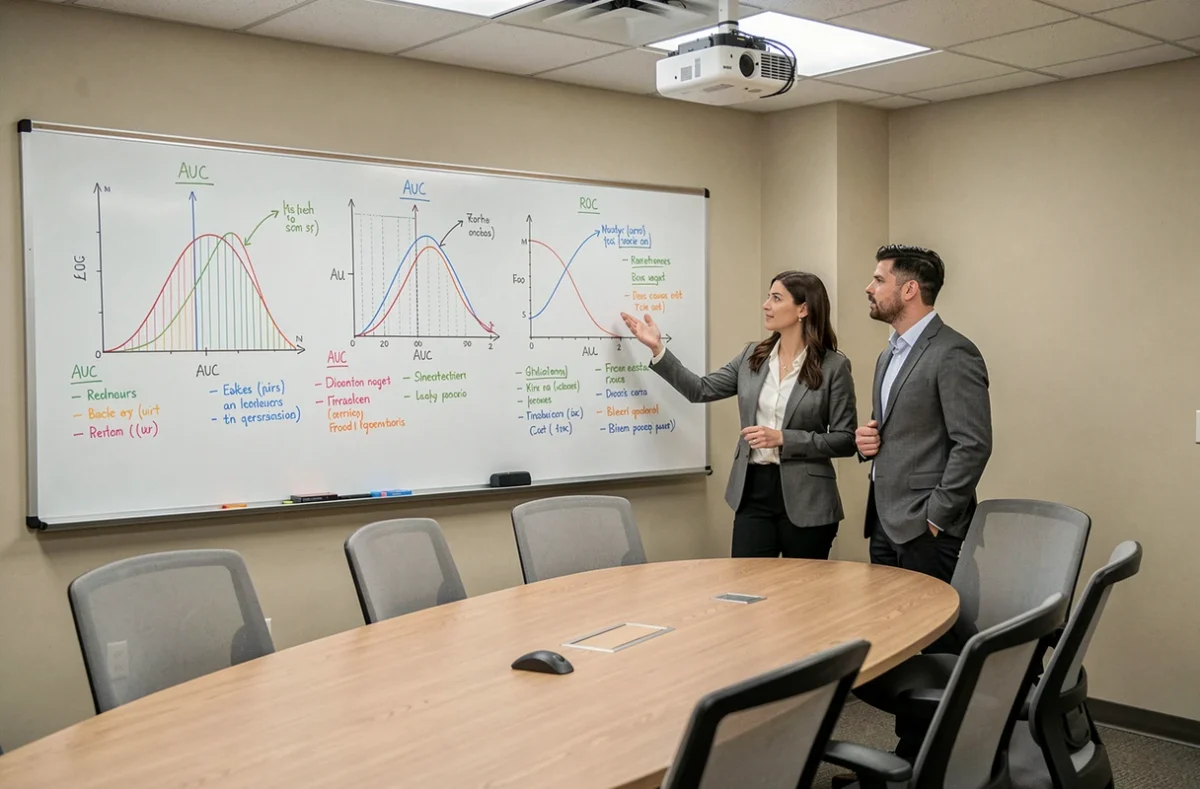
Ce qui change avec l’IA médicale et la surveillance post-déploiement
Les algorithmes d’intelligence artificielle appliqués au diagnostic (imagerie, analyse de signaux, scores prédictifs) sont évalués avec la même métrique A.U.C. lors de leur développement. Un modèle de détection de rétinopathie diabétique affiche typiquement une A.U.C. élevée sur les jeux de données d’entraînement.
Le cadre réglementaire a évolué. L’AI Act européen impose désormais une logique qui dépasse la simple bonne A.U.C. : performance, robustesse, cybersécurité et supervision humaine deviennent des critères d’évaluation. De son côté, la FDA explore des tests « par compétences » pour l’IA générative médicale, inspirés de l’évaluation des cliniciens, couvrant les connaissances cliniques, la sécurité comportementale et la généralisation.
Au Royaume-Uni, les recommandations récentes vont vers une surveillance post-déploiement continue des outils d’IA médicale, avec autorisation progressive et remontée des incidents terrain. On s’éloigne du modèle où une A.U.C. validée une fois en laboratoire suffisait à justifier l’usage clinique.
- L’A.U.C. mesurée en développement peut se dégrader quand l’outil est déployé sur des populations différentes de celles de l’entraînement.
- Un suivi continu des performances (monitoring post-market) devient la norme attendue par les régulateurs.
- Les données terrain remontent des écarts que les métriques initiales ne captent pas : biais de population, dérive du modèle, cas limites non représentés.
Au-delà de la métrique : la décision reste clinique
L’A.U.C. reste un repère solide pour comparer des tests diagnostiques et filtrer les outils qui ne discriminent pas. Elle ne remplace pas le raisonnement clinique qui intègre la prévalence locale, le profil du patient et le coût d’une erreur. Un bon test mal utilisé produit de mauvaises décisions, quel que soit son score sous la courbe.